

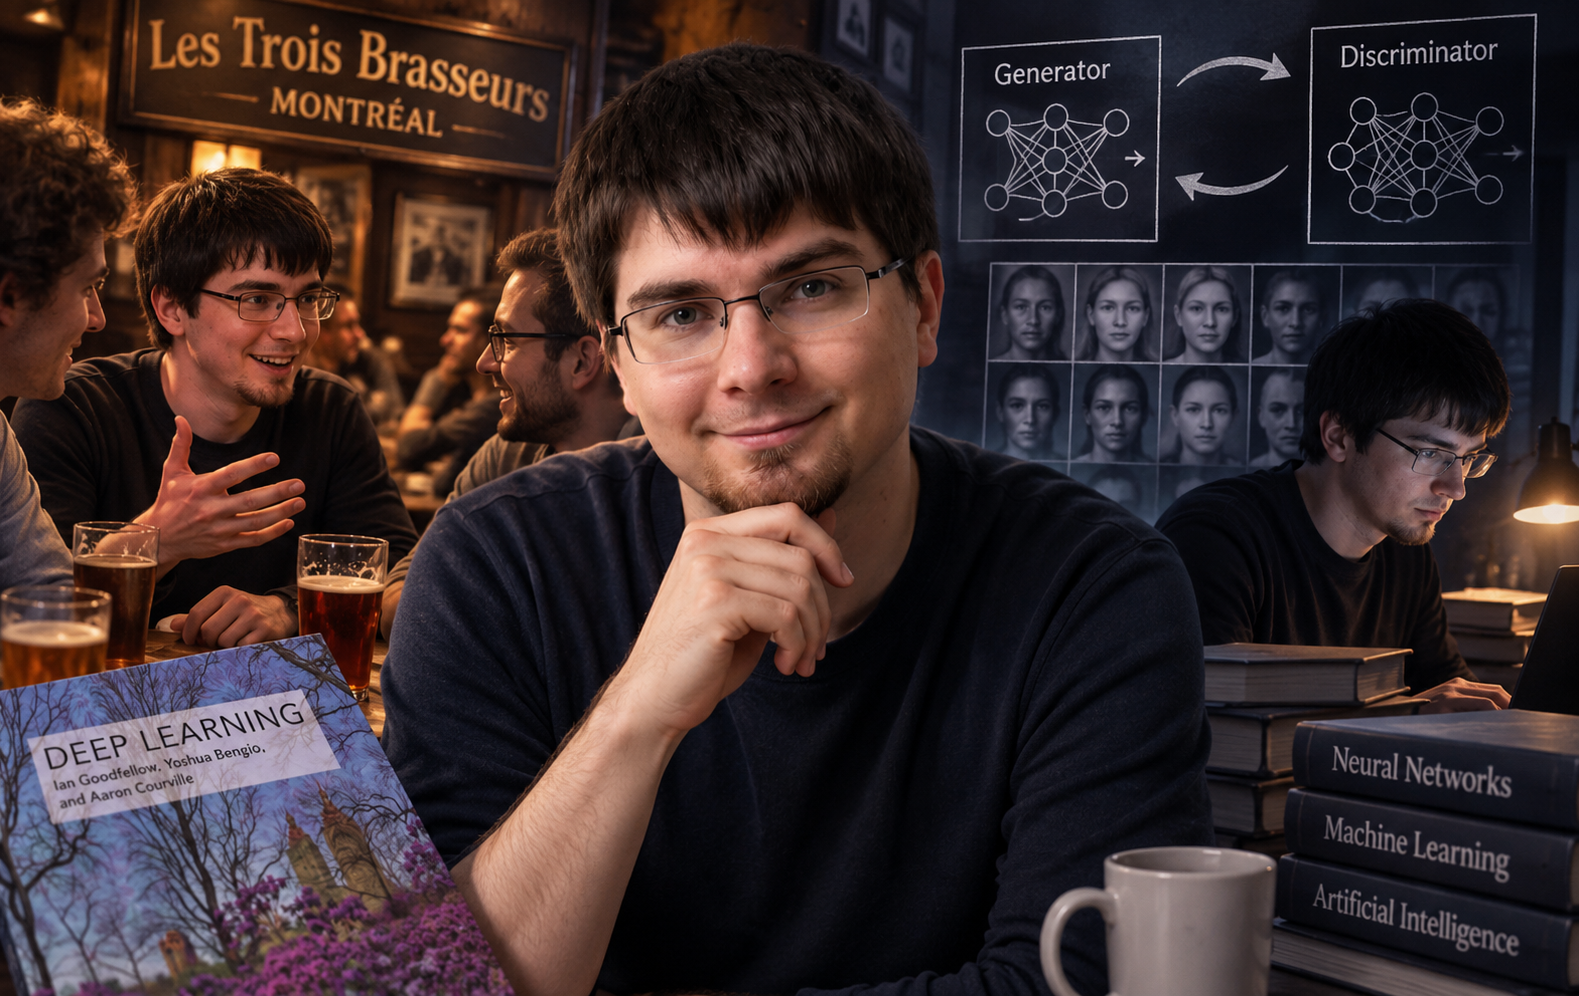
Ідея після пива: як випадкова суперечка в барі створила GAN і навчила ШІ уявляти
Генеративно-змагальні мережі (GAN) стали фундаментом для сучасного генеративного мистецтва та дипфейків. Їхня архітектура народилася не в стерильній лабораторії, а під час неформальної дискусії в монреальському барі.
Чи може вечірка з друзями стати початком технологічної революції? У 2014 році Іан Гудфеллоу довів, що так. Під час святкування випуску з аспірантури він вступив у палку суперечку з колегами про те, як навчити комп’ютер автоматично створювати реалістичні зображення. Відповідь прийшла під час обговорення проблем навчання генеративних моделей: замість однієї мережі потрібно створити дві, які будуть боротися одна з одною. Невдовзі після цієї розмови Гудфеллоу реалізував прототип, який підтвердив життєздатність його ідеї.
Основні тези
- Архітектура GAN базується на змаганні Генератора, що створює підробки, та Дискримінатора, що їх викриває.
- Метод дозволив ШІ перейти від простого розпізнавання об’єктів до їхнього синтезу.
- В основі роботи мереж лежить теорія ігор (minimax game), а не просто накопичення даних.
Іан Гудфеллоу запропонував систему, де дві нейронні мережі мають протилежні цілі. Генератор намагається створити такий зразок, який виглядатиме як справжній. Дискримінатор, у свою чергу, вчиться відрізняти підробку від оригіналу.
Цей процес працює як запекле протистояння фальшивомонетника та експерта з валют.
Коли Дискримінатор викриває помилку, Генератор отримує сигнал і коригує свої параметри, щоб наступного разу бути переконливішим. З часом якість підробок зростає настільки, що людина або інша модель вже не можуть відрізнити синтетичне зображення від реального.
Але чому цей метод виявився ефективнішим за попередні підходи?
Такий підхід дозволив машинам фактично «уявити» об’єкт. Якщо раніше ШІ міг лише ідентифікувати кота на фото, то з GAN система змогла створити зображення кота з нуля. Деякі дослідники аналізують цей механізм через призму тесту Тьюринга і навіть пропонують термін «Turing Learning» для узагальнення подібних підходів, проте офіційно архітектура GAN базується на теорії ігор.
Сьогодні GAN використовують для відновлення пошкоджених фотографій, створення облич для відеоігор та генерації медичних даних. У 2024 році наукова спільнота визнала фундаментальний вплив цієї роботи на розвиток штучного інтелекту протягом останнього десятиліття, присудивши статті Гудфеллоу престижну премію NeurIPS ‘Test of Time’.
“Винахід GAN — ідеї, сформульованої під час невимушеної суперечки в барі, доводить, що наукові прориви часто покладаються на неструктуровану творчість так само сильно, як і на навмисну лабораторну роботу”, — Ян Ґудфеллоу.
Попри колосальний успіх, технологія створила нові ризики. Здатність GAN створювати майже ідеальні підробки зробила дипфейки критичною проблемою для глобальної безпеки. Тепер світ перебуває в стані постійної гонки між розробниками синтетичного контенту та спеціалістами з його виявлення.
Чому це важливо
Поява GAN стала яскравим прикладом серендипності — здатності робити відкриття через випадкові обставини та спостереження. Системна гнучкість мислення в неформальній обстановці дозволила обійти обмеження лінійного наукового пошуку. Це призвело до створення архітектури, яка надала машинам інструмент для синтезу реальності.
GAN докорінно змінили економіку контенту. Вартість створення візуального образу впала майже до нуля, що змушує нас переглянути самі поняття авторства та автентичності цифрових даних.
Цей випадок демонструє, що найбільш ефективні рішення в AI часто приходять не через просте накопичення великих масивів даних, а через моделювання природних конфліктів та змагань.
Які моделі ШІ для зображень обрати
Ринок генеративного мистецтва перейшов від епохи випадкових результатів до епохи технічної точності та швидкості.
Чи може нейромережа повністю замінити рендер-студію, якщо вона створює ідеальний метал і скло за чотири секунди? Сьогодні цей запит стає реальністю завдяки новим архітектурним рішенням техгігантів.
Моделі сімейства Nano Banana, що є частиною екосистеми Gemini, стали інструментом для тих, кому потрібен результат без артефактів. Зокрема, Gemini 3.1 Flash Image базується на архітектурі Nano Banana.
Ці моделі, включаючи Nano Banana Pro, є офіційними ідентифікаторами, що використовуються в API та Google AI Studio, замінивши застарілі рішення Imagen. Завдяки архітектурі DiT (Diffusion Transformer) та використанню TPU, генерація кадру 1024×1024 займає близько 4 секунд. Використання спеціалізованого заліза дозволило скоротити час обробки запиту в кілька разів порівняно з моделями 2024 року.
Головна перевага Nano Banana полягає в роботі з текстом. Модель коректно рендерить фрази довжиною понад 15 слів, не спотворюючи літери та кегль. Це дозволяє створювати макети упаковки та рекламні банери без додаткової обробки. Проте за точністю стоїть «стоковий» вигляд: зображення часто виглядають занадто ідеальними.
Але чи завжди ідеальність є перевагою?
OpenAI з DALL-E 3 утримує лідерство в семантичному розумінні. Модель найкраще справляється зі складними запитами, де важливо зберегти логічний зв’язок між об’єктами. Це відбувається тому, що DALL-E 3 глибше інтегрована з мовними моделями для аналізу контексту.
Midjourney v6.1 залишається вибором для концепт-артистів. На відміну від стерильного підходу Google, Midjourney має виражений художній стиль, що дозволяє створювати атмосферні роботи. Проте Midjourney програє в точності деталей та швидкості редагування.
Особисто я віддаю перевагу саме OpenAI. Мій досвід викоритстання показує, що їх модель мене найшвидше і найкраще “розуміє” і створює чудові зображення.